Ein Forschungsteam von Max-Planck-Institut, Ruhr-Universität Bochum und TU Delft hat untersucht, was ChatGPT sich über seine Nutzer merkt - und stieß auf ein besorgniserregendes Ungleichgewicht: 96 Prozent der gespeicherten Erinnerungen entstehen ohne direkte Aufforderung durch die Nutzer. Viele davon enthalten sensible persönliche und psychologische Informationen.
In den vergangenen Jahren haben ChatGPT, Gemini und Claude eine neue Funktion eingeführt: das „Memory“ (Gedächtnis). Damit können die KI-Systeme Informationen aus früheren Gesprächen speichern und in späteren Unterhaltungen wieder aufgreifen, beispielsweise Vorlieben, wiederkehrende Aufgaben oder persönliche Ziele. Das soll die Antworten persönlicher und zusammenhängender machen.
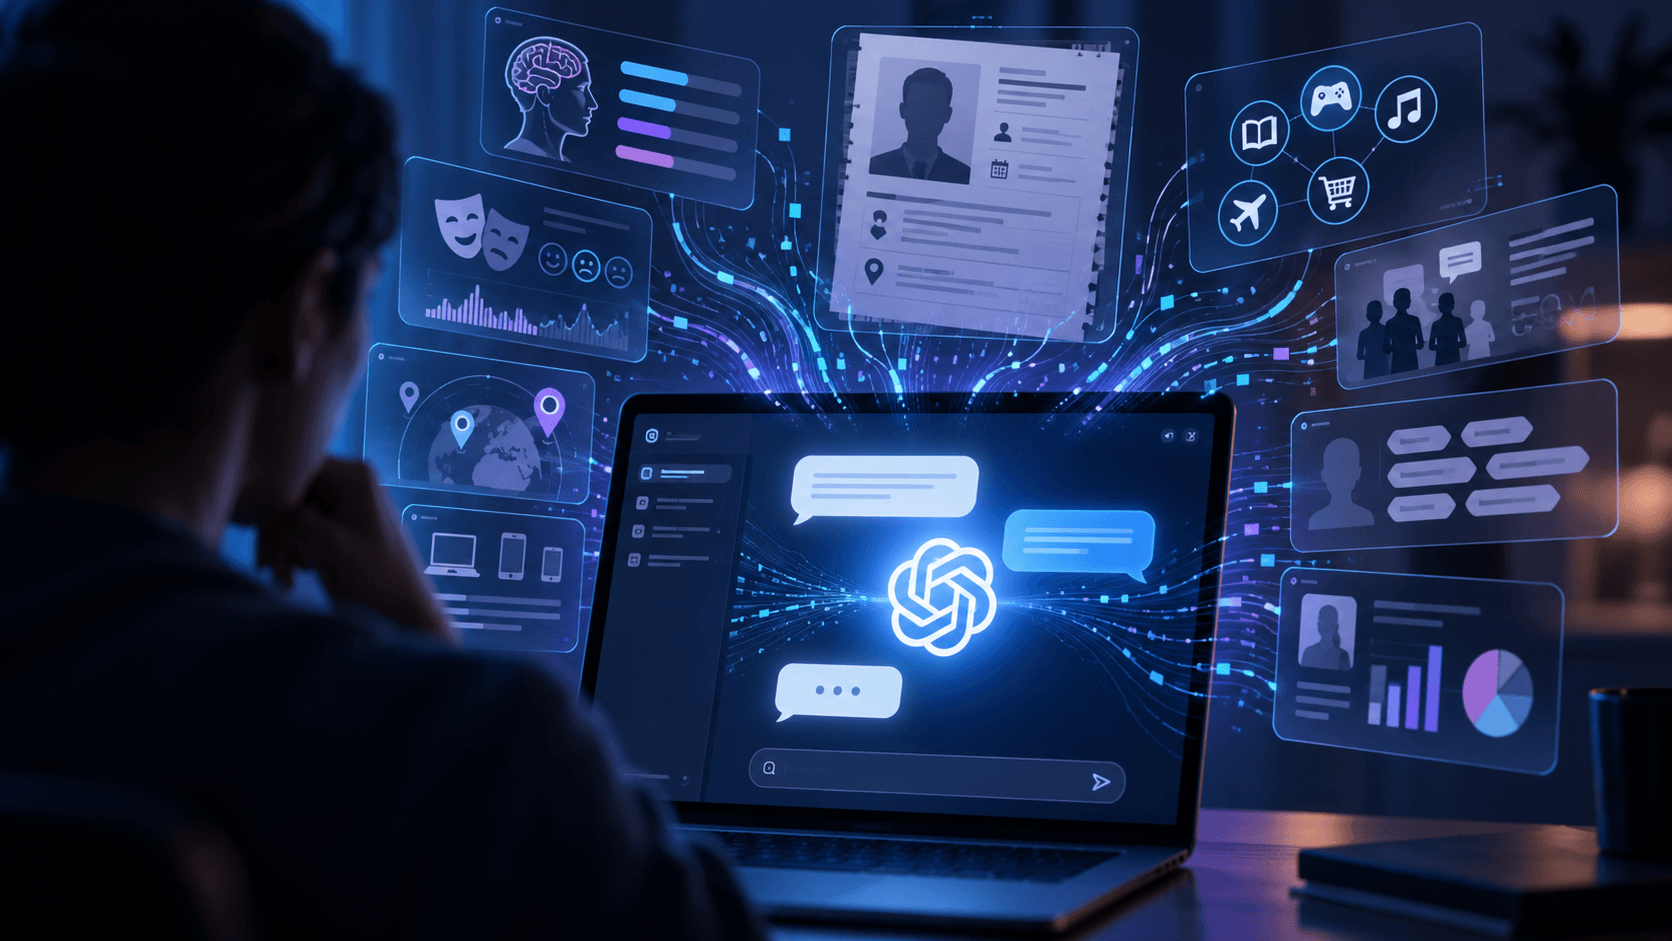
Doch was genau wird in diesem Gedächtnis gespeichert? Und wer entscheidet darüber? Die Forschenden Abhisek Dash, Soumi Das, Elisabeth Kirsten und Qinyuan Wu bezeichnen das Ergebnis als „algorithmisches Selbstporträt“: ein Bild, das die KI aus den Selbstoffenbarungen der Nutzer in privaten Gesprächen erstellt.
Ihre auf der WWW '26-Konferenz veröffentlichte Studie analysiert 2.050 Gedächtnis-Einträge von 80 echten ChatGPT-Nutzern. Die Daten stammen aus sogenannten GDPR-Datenspenden. Die Nutzer hatten ihr Recht auf Datenkopie gemäß der DSGVO genutzt und ihre ChatGPT-Verläufe der Forschung zur Verfügung gestellt.
Die wichtigsten Befunde
1. Das System entscheidet - nicht der Nutzer
Laut OpenAI sollen Nutzer die Kontrolle darüber haben, was gespeichert wird. Eine Analyse ergab jedoch, dass nur 4 Prozent der Gedächtnis-Einträge (84 von 2.050) auf eine explizite Nutzeranfrage zurückgingen, zum Beispiel „Merke dir, dass ich Vegetarier bin”. Die übrigen 96 Prozent wurden vom System selbstständig angelegt, ohne dass der Nutzer darum gebeten hatte.
Das ist insofern bemerkenswert, als dass OpenAI in seinen Richtlinien zwar einräumt, dass ChatGPT Informationen „ohne Aufforderung“ speichern kann, wenn es sie für nützlich hält. Die Studie zeigt jedoch, wie stark diese implizite Praxis dominiert und dass die Nutzer faktisch kaum Einfluss darauf haben, welche Informationen in ihrem „Selbstporträt” gespeichert werden.
2. Sensible Daten landen im Gedächtnis - entgegen den Richtlinien
OpenAI betont, dass ChatGPT darauf trainiert sei, keine sensiblen Informationen wie Gesundheitsdaten, religiöse Überzeugungen oder sexuelle Orientierung proaktiv zu speichern. Die Realität sieht jedoch anders aus.
- 28 Prozent der Einträge enthalten personenbezogene Daten im Sinne der DSGVO.
- 7 Prozent enthalten sogar „besondere Kategorien" personenbezogener Daten (Artikel 9 DSGVO), also besonders schützenswerte Informationen.
- Bei 91 Prozent der Teilnehmenden fanden sich personenbezogene Daten im Gedächtnis, bei 54 Prozent sogar besondere Kategorien.
- Am häufigsten vertreten: Namen (41 Prozent), gefolgt von wirtschaftlichen, sozialen und kulturellen Identitätsmerkmalen (40 Prozent). Bei den besonderen Kategorien dominiert Gesundheit (61 Prozent der Einträge mit besonderen Daten).
3. Die KI erstellt psychologische Profile
Der vielleicht interessanteste Befund: 52 Prozent der Gedächtnis-Einträge enthalten psychologische Informationen über die Nutzer - also nicht nur Fakten wie „Nutzer heißt X“, sondern auch Wünsche, Absichten, Überzeugungen oder Emotionen. Die Forschenden nutzen dafür das Konzept der „Theory of Mind“, also die Fähigkeit, mentale Zustände anderer zu erfassen und zu beschreiben.
Die Verteilung ist aufschlussreich:
- Wünsche (Desires): 73 Prozent der psychologischen Einträge
- Absichten (Intentions): 16 Prozent
- Emotionen: 14 Prozent
- Überzeugungen (Beliefs): 11 Prozent
- Wissen, Wahrnehmungen, mentalistische Deutungen: jeweils unter 10 Prozent
Das System speichert also bevorzugt längerfristige motivationale Muster - also das, was die Nutzer wollen und anstreben -, nicht flüchtige Gefühlszustände. Die Forschenden erklären dies mit der Funktion des Systems: ChatGPT soll kohärente, langfristige Interaktionen ermöglichen. Dafür sind Informationen über Ziele und Überzeugungen nützlicher als momentane Stimmungen. Dadurch unterscheidet sich die KI auch von klassischen Plattformen wie TikTok oder Instagram, die eher breite Interessenkategorien zu Werbezwecken sammeln.
4. Die Erinnerungen sind überwiegend im Nutzerkontext verankert - aber nicht immer
Die gute Nachricht: 84 Prozent der Einträge sind direkt im Nutzertext verankert. Das System halluziniert also nicht einfach, sondern fasst zusammen, paraphrasiert oder leitet logisch aus dem Nutzertext ab. Die semantische Ähnlichkeit zwischen dem Gedächtnis-Eintrag und dem ursprünglichen Gesprächskontext ist durchweg hoch.
Allerdings gibt es auch Fälle, in denen das System extrapoliert: Wenn ein Nutzer etwa nach Bands ähnlich wie Nirvana fragt, speichert ChatGPT „Nutzer mag Nirvana“ - eine Annahme, die nicht explizit geäußert wurde. In anderen Fällen werden Dateianhänge oder Kontextinformationen nicht ausreichend berücksichtigt, was zu weniger fundierten Einträgen führt.
5. Das Gedächtnis lässt sich nachbauen - und das ist ein Risiko
Den Forschenden gelang es, die Gedächtnis-Extraktion von ChatGPT mit Open-Source-Modellen (Qwen2.5, Gemma3 und GPT-OSS) nachzuahmen. Dabei wurde eine semantische Ähnlichkeit von rund 60 Prozent zu den echten ChatGPT-Erinnerungen erreicht. Das zeigt: Der Prozess ist vorhersagbar und potenziell reproduzierbar.
Das bedeutet, dass ein Angreifer nicht einmal direkten Zugriff auf das gespeicherte ChatGPT-Gedächtnis haben muss. Hat er Zugriff auf ausreichend Chatverläufe, kann er daraus ein vergleichbares Profil selbst erstellen.
6. Gegenmaßnahme: Der „Attribution Shield"
Als Antwort auf diese Risiken haben die Forschenden ein Framework entwickelt, das Nutzeranfragen so umformuliert, dass persönliche Informationen nicht mehr zugeordnet werden können, ohne den eigentlichen Zweck der Anfrage aus den Augen zu verlieren. Ein Beispiel:
Original: „Ich muss wirklich aufhören, Cannabis zu rauchen."
Umformuliert: „Was sind einige Strategien, um mit dem Cannabis-Konsum aufzuhören?"
Über 94 Prozent der umformulierten Anfragen verhinderten eine persönliche Zuordnung, während die semantische Ähnlichkeit zur ursprünglichen Anfrage - also der Nutzen - erhalten blieb. Die Antworten der KI auf die umformulierten Anfragen waren nahezu identisch mit den Antworten auf die Originalanfragen.
Was bedeutet das?
Die Studie beschreibt einen grundlegenden Wandel in der Personalisierung: Weg von der Sammlung von Verhaltensdaten (Klicks, Likes, Surfverhalten), hin zu einem intimen psychologischen Profil, das aus privaten Gesprächen destilliert wird. Das betrifft nicht nur den Datenschutz, sondern auch die Autonomie und Selbstbestimmung: Wer bestimmt eigentlich, wie wir von der KI wahrgenommen werden?
Die Forschenden betonen, dass ihre Ergebnisse auf einer relativ kleinen, jedoch ökologisch validen Stichprobe von 80 Nutzern, die überwiegend aus den USA und Europa stammen, beruhen. Dennoch sehen sie die Ergebnisse als Warnsignal: Die wachsende Verbreitung von KI-Chatbots mit Gedächtnisfunktion mache es dringend erforderlich, dass Entwickler Werkzeuge für echte Kontrolle bereitstellen und politische Rahmenbedingungen den Schutz der „algorithmischen Selbstporträts” sicherstellen.
In seinen FAQ räumt OpenAI selbst ein: „Wenn Sie Informationen teilen, die für zukünftige Gespräche nützlich sein könnten, speichert ChatGPT diese möglicherweise als Erinnerung, ohne dass Sie darum bitten müssen.“ Und weiter: „Bitte vermeiden Sie die Eingabe von Informationen, die Sie nicht gespeichert haben möchten.“
Fazit
Die „Memory“-Funktion von ChatGPT ist leistungsstark und zeichnet ein Bild von uns, das wir oft nicht kontrollieren können. Eine Studie liefert erstmals empirische Einblicke in die Daten, die das System tatsächlich über uns speichert: Dazu gehören Namen, Gesundheitsdaten, Wünsche, Absichten und Überzeugungen. Vieles davon ist sensibel und manches widerspricht sogar den eigenen Richtlinien des Herstellers.
Die gute Nachricht ist, dass Erinnerungen meist treu und nachvollziehbar sind. Die schlechte Nachricht ist, dass sie fast immer ohne unsere Zustimmung entstehen. Und die Werkzeuge, die uns Kontrolle geben sollen, greifen zu kurz, solange das System selbst entscheidet, was „nützlich” ist.
Ich finde, das ist der entscheidende Punkt - und er geht über Datenschutz im engeren Sinne hinaus. Wenn eine KI aus privaten Gesprächen ein psychologisches Profil destilliert, dann ist das keine neutrale Zusammenfassung, sondern eine Deutung: Das System entscheidet, welche Wünsche, Absichten und Überzeugungen als „charakteristisch” für mich gelten und welche nicht. Diese Deutung kann falsch oder verzerrt sein und bleibt mir oft verborgen. Dass OpenAI in den FAQ die Verantwortung an die Nutzer weiterreicht („Vermeiden Sie Eingaben, die Sie nicht gespeichert haben möchten”), halte ich für zu bequem. Wer nicht weiß, was gespeichert wird, kann es auch nicht gezielt vermeiden. Die Beweislast liegt hierbei beim Hersteller und nicht beim Nutzer.
Um zu verhindern, dass ChatGPT ein psychologisches Profil anlegt, bleibt derzeit nur, die Memory-Funktion in den Einstellungen zu deaktivieren oder regelmäßig zu prüfen, was das System sich gemerkt hat. Beides ist besser als nichts, aber keine echte Kontrolle, sondern lediglich Schadensbegrenzung. Eine KI, die implizit speichert, was sie für „nützlich” hält, bräuchte strengere Vorgaben: standardmäßig deaktiviert, explizite Zustimmung pro Eintrag, klare Anzeige dessen, was extrahiert wurde - und zwar bevor es in zukünftige Antworten einfließt. Solange das fehlt, bleibt das „algorithmische Selbstporträt” ein Bild, das andere von uns zeichnen - und das wir nur mühsam korrigieren können.
Für die Analyse und sprachliche Aufbereitung dieses Artikels habe ich KI-Werkzeuge unterstützend eingesetzt. Alle Inhalte, Zahlen, Zitate und Schlussfolgerungen habe ich selbst am Originaldokument geprüft und gegengelesen. Die KI diente mir lediglich als Hilfsmittel zur Strukturierung und Verständlichkeitsprüfung.